Che cos'è l'edge AI?
Come funziona l'edge AI: perché l'inferenza esce dal cloud, le fasce hardware, come si riducono i modelli con quantizzazione e pruning, e quando evitarla.
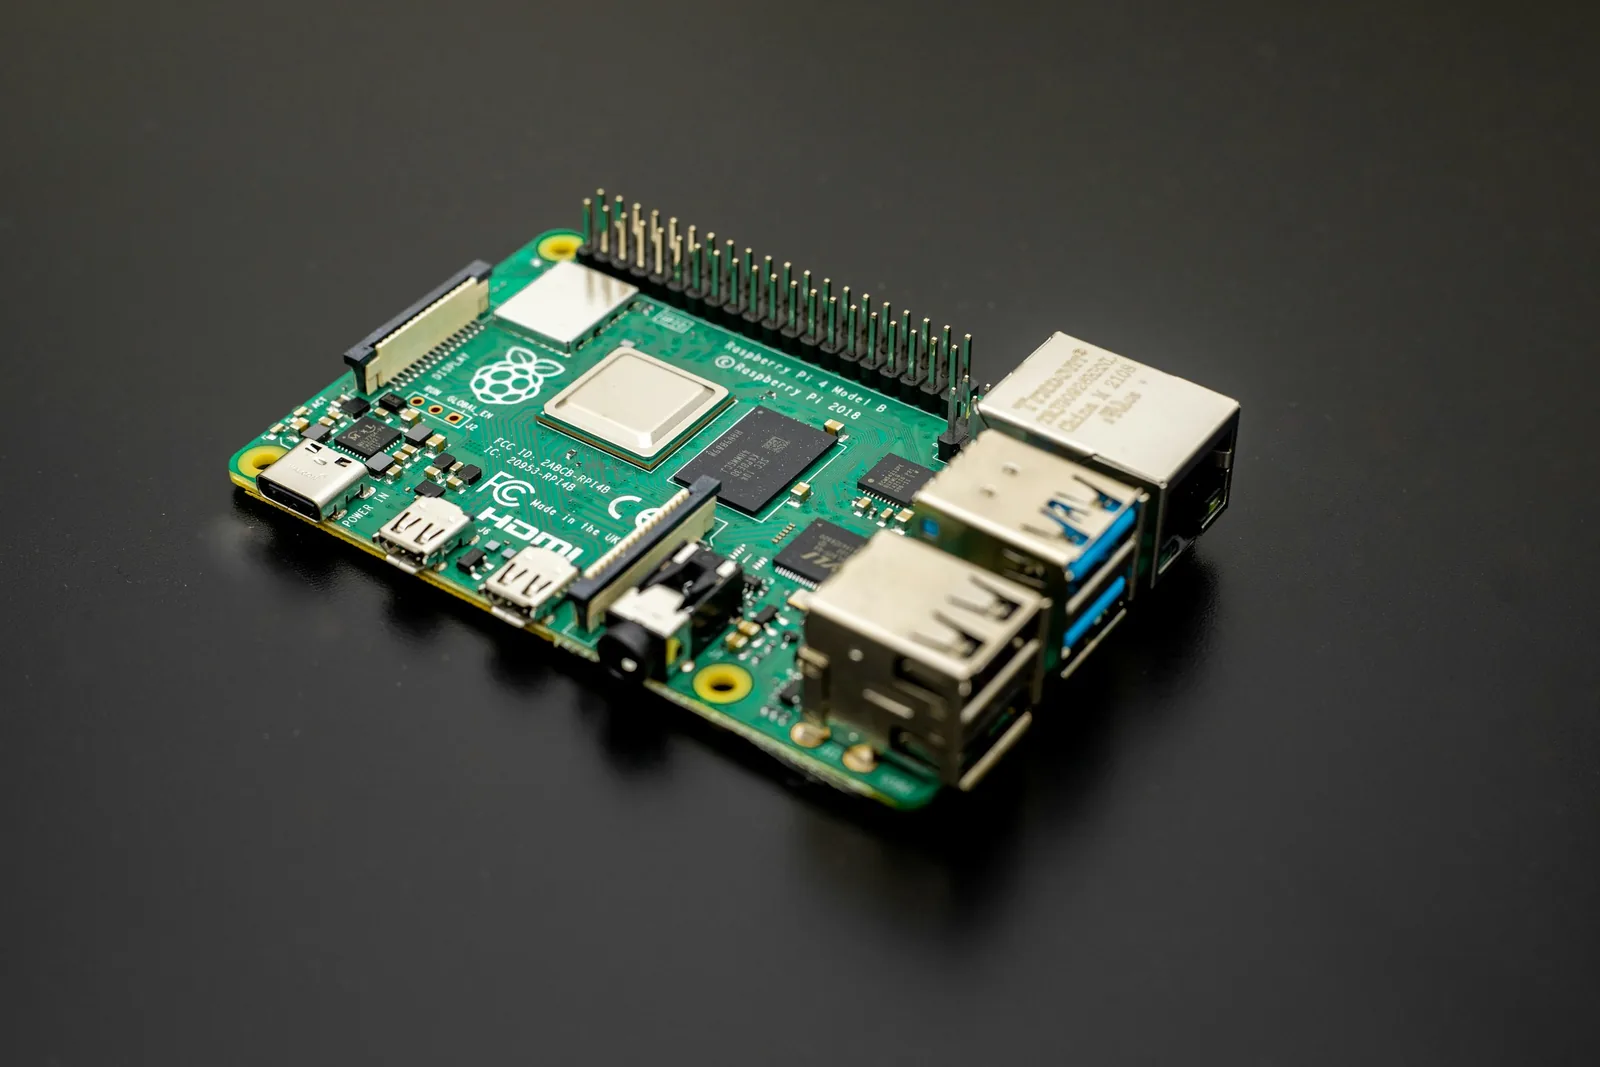
Foto: Jainath Ponnala / Unsplash
Dopo aver letto questo articolo saprai:
- Spiegare perché l'inferenza esce dal cloud e passa sui dispositivi
- Collocare un carico di lavoro sulla fascia hardware giusta, dall'MCU al modulo GPU
- Descrivere come quantizzazione e pruning fanno stare un modello su un dispositivo piccolo
In questa pagina
L’edge AI consiste nell’eseguire un modello di machine learning addestrato vicino al punto in cui i dati vengono prodotti, su un gateway, un PC industriale, una telecamera o il dispositivo stesso, invece di inviare i dati a un servizio cloud e aspettare la risposta. Il modello, di norma, viene ancora addestrato nel cloud o su una workstation. Ciò che si sposta all’edge è l’inferenza, cioè l’atto di far passare dati nuovi attraverso il modello per ottenere una previsione.
L’idea è più vecchia dell’attuale ondata di interesse. Gli ingegneri embedded consegnano da decenni classificatori basati sull’elaborazione dei segnali. Quello che è cambiato è che le reti neurali sono diventate l’approccio dominante ai problemi di visione, audio e serie temporali, e che gli strumenti per ridurre quelle reti ed eseguirle su hardware a risorse limitate sono maturati. Oggi un modello che dieci anni fa avrebbe richiesto un rack di server può girare su un chip che costa pochi dollari.
Questa guida tratta le ragioni per eseguire l’inferenza all’edge, lo spettro dell’hardware, le tecniche per far stare i modelli nella memoria disponibile, i runtime che incontrerai e il carico operativo che arriva con una flotta di dispositivi ognuno con la propria copia di un modello.
Perché spostare l’inferenza fuori dal cloud?
Le ragioni ricorrenti sono cinque, e a un progetto di solito ne interessano due o tre.
Latenza: un’andata e ritorno verso una regione cloud richiede da decine a centinaia di millisecondi e varia con le condizioni della rete. Una protezione macchina che deve fermare una pressa, o una telecamera che deve decidere prima che passi un veicolo, non possono aspettare tanto.
Banda: una telecamera produce molti più dati di quanti un collegamento cellulare possa trasportare in modo economico. Eseguire il rilevamento in locale e inviare solo eventi, conteggi o miniature riduce il traffico di ordini di grandezza.
Privacy e sovranità dei dati: il video di un reparto produttivo, l’audio di una casa o i parametri vitali di un paziente possono essere soggetti a norme che vietano di portare i dati grezzi fuori sede. L’inferenza locale permette di tenere il segnale grezzo dove è stato acquisito ed esportare solo i risultati derivati.
Disponibilità: un sito con connettività intermittente deve funzionare comunque. Un gateway che esegue i propri modelli continua a prendere decisioni mentre l’uplink è giù e si sincronizza più tardi.
Costo: l’inferenza nel cloud si paga per chiamata o per ora di GPU. Per carichi di lavoro ad alta frequenza, come l’analisi video fotogramma per fotogramma, un acquisto hardware una tantum è spesso più economico sull’intera vita del deployment.
Quale hardware esegue l’edge AI?
L’hardware per l’edge AI copre diversi ordini di grandezza di capacità, e scegliere la fascia giusta è gran parte del lavoro di progettazione.
In fondo ci sono i microcontrollori: componenti di classe Arm Cortex-M e la famiglia ESP32, con centinaia di kilobyte di RAM e nessun sistema operativo oltre a un eventuale RTOS. Qui i modelli si misurano in decine di kilobyte. Questa fascia è l’argomento della guida al TinyML.
Poi vengono i microprocessori di classe applicativa con Linux, come un Raspberry Pi o un modulo NXP i.MX. Possono eseguire runtime standard e modelli di pochi megabyte a qualche fotogramma al secondo con la sola CPU.
Molti di questi chip includono ormai una neural processing unit, un blocco progettato per le operazioni di moltiplicazione e accumulo che dominano la matematica delle reti neurali. Una NPU esegue lo stesso modello molte volte più velocemente e con minore consumo rispetto alla CPU, ma solo per gli operatori che supporta, e solo attraverso il compilatore e il runtime del fornitore. Tra gli esempi ci sono i core Arm Ethos-U, la NPU dell’NXP i.MX 8M Plus e i motori AI dei SoC Qualcomm e MediaTek. Acceleratori discreti come il Google Coral Edge TPU e i moduli Hailo-8 si collegano alle schede esistenti via USB o PCIe.
In cima ci sono le GPU edge, la più visibile delle quali è la famiglia NVIDIA Jetson, e i PC industriali con schede grafiche discrete. Eseguono pipeline multi-telecamera e modelli più grandi, compresi piccoli modelli linguistici, al prezzo di decine di watt e di un raffreddamento attivo.
Come si fa stare un modello?
Un modello addestrato per un server raramente è utilizzabile così com’è. Tre tecniche fanno la maggior parte del lavoro di riduzione.
La quantizzazione sostituisce pesi e attivazioni in virgola mobile a 32 bit con interi a precisione inferiore, più spesso a 8 bit. Da sola riduce la dimensione del modello di circa quattro volte e permette all’hardware che lavora solo con interi, comprese la maggior parte delle NPU e tutti i microcontrollori, di eseguirlo in modo efficiente. La quantizzazione post-addestramento richiede solo un piccolo dataset di calibrazione; l’addestramento consapevole della quantizzazione (quantization-aware training) simula la precisione ridotta durante l’addestramento e recupera gran parte della perdita di accuratezza. Esistono schemi a 4 bit e a precisione mista per i modelli più grandi, ma sono supportati in modo meno universale.
Il pruning (potatura) rimuove i pesi o gli interi canali che contribuiscono poco al risultato. Il pruning non strutturato produce matrici sparse, utili solo se il runtime sfrutta la sparsità; il pruning strutturato rimuove interi filtri e produce una rete realmente più piccola e più veloce su qualsiasi hardware.
La distillazione della conoscenza (knowledge distillation) addestra un piccolo modello “studente” a imitare un grande modello “insegnante”, ottenendo spesso un’accuratezza migliore, a parità di dimensione, rispetto all’addestramento diretto del modello piccolo.
Accanto a queste tecniche, l’architettura del modello conta più di qualsiasi trucco di compressione. Le famiglie progettate per l’uso mobile ed embedded, come MobileNet ed EfficientNet-Lite per la visione, cedono un po’ di accuratezza in cambio di molte meno operazioni, e partire da una di esse è di solito la prima mossa migliore.
Quali runtime e toolchain incontrerai?
Un modello edge ha bisogno di un runtime, una libreria che carica il file del modello e lo esegue. I più comuni sono LiteRT, il runtime che prima si chiamava TensorFlow Lite e che ha una variante per microcontrollori, LiteRT for Microcontrollers, per i target bare metal; ONNX Runtime, che esegue modelli esportati da PyTorch e da altri framework; e ExecuTorch, il runtime di PyTorch per il deployment mobile ed embedded.
I produttori di hardware aggiungono sopra a questi i propri strumenti. Intel OpenVINO, NVIDIA TensorRT e i compilatori per NPU di Arm, NXP, Qualcomm e altri prendono un modello standard e lo compilano in una forma che il loro acceleratore può eseguire. In pratica, scegliere un chip significa vincolarsi al suo compilatore e all’insieme di operatori che accelera, e un modello che usa un operatore non supportato ricade silenziosamente sul percorso lento della CPU.
Piattaforme come Edge Impulse incapsulano l’intero flusso, dalla raccolta e dall’etichettatura dei dati all’addestramento, alla quantizzazione e all’esportazione di una libreria C++, il che abbassa la barriera d’ingresso per i team senza uno specialista di ML.
Come si distribuiscono e si gestiscono i modelli edge?
Un modello all’edge è a tutti gli effetti un pezzo di firmware. Va versionato, firmato, distribuito tramite aggiornamenti OTA e riportato alla versione precedente con un rollback quando si comporta male. La guida alla gestione dei dispositivi tratta questi meccanismi.
Il problema più difficile è capire quando un modello è diventato obsoleto. Il drift del modello si manifesta come un lento cambiamento nella distribuzione delle previsioni, per esempio un tasso crescente di output a bassa confidenza. Inviare a monte un campione di input e previsioni per la revisione, e mantenere per ogni sito un insieme di dati etichettati di controllo (holdout set), sono le difese pratiche. La disciplina che fa tutto questo in modo sistematico è l’MLOps, e non arriva gratis con una piattaforma IoT.
Quando non usare l’edge AI?
L’edge AI è la scelta sbagliata quando il modello è troppo grande per stare sul dispositivo senza una perdita di accuratezza inaccettabile, quando cambia così spesso che gli aggiornamenti dell’intera flotta diventano il collo di bottiglia, o quando il segnale di valore viene dal confronto tra molti dispositivi, cosa che solo un sistema centrale può fare. È anche eccessiva per la telemetria a bassa frequenza, come le letture orarie di temperatura, dove inviare i numeri grezzi al cloud costa quasi nulla e mantiene semplice il dispositivo.
Un ibrido comune e sensato esegue un modello economico all’edge per filtrare e uno più grande nel cloud per confermare. Il modello edge decide cosa vale la pena inviare; il modello cloud ha l’ultima parola, e i suoi disaccordi con il modello edge diventano dati di addestramento per la versione successiva.
Per continuare
- TinyML spiegato scende fino alla fascia dei microcontrollori.
- Visione artificiale sul dispositivo per l’IoT applica queste idee alle telecamere.
- Edge computing spiegato tratta l’infrastruttura che ospita l’inferenza edge.
- Edge, cloud o fog inquadra la decisione generale su dove collocare l’elaborazione.
- 17 ottobre 2026: fonti collegate; nomi di acceleratori e runtime resi precisi (Ethos-U, Hailo-8, LiteRT for Microcontrollers)
Come gestiamo le correzioni: politica editoriale (in inglese).
Argomenti: edge AI, inferenza, quantizzazione, NPU