Che cos'è il TinyML?
Il TinyML esegue reti neurali su microcontrollori con pochi kilobyte di RAM. Scopri i vincoli, il flusso di lavoro, i framework e i carichi di lavoro adatti.
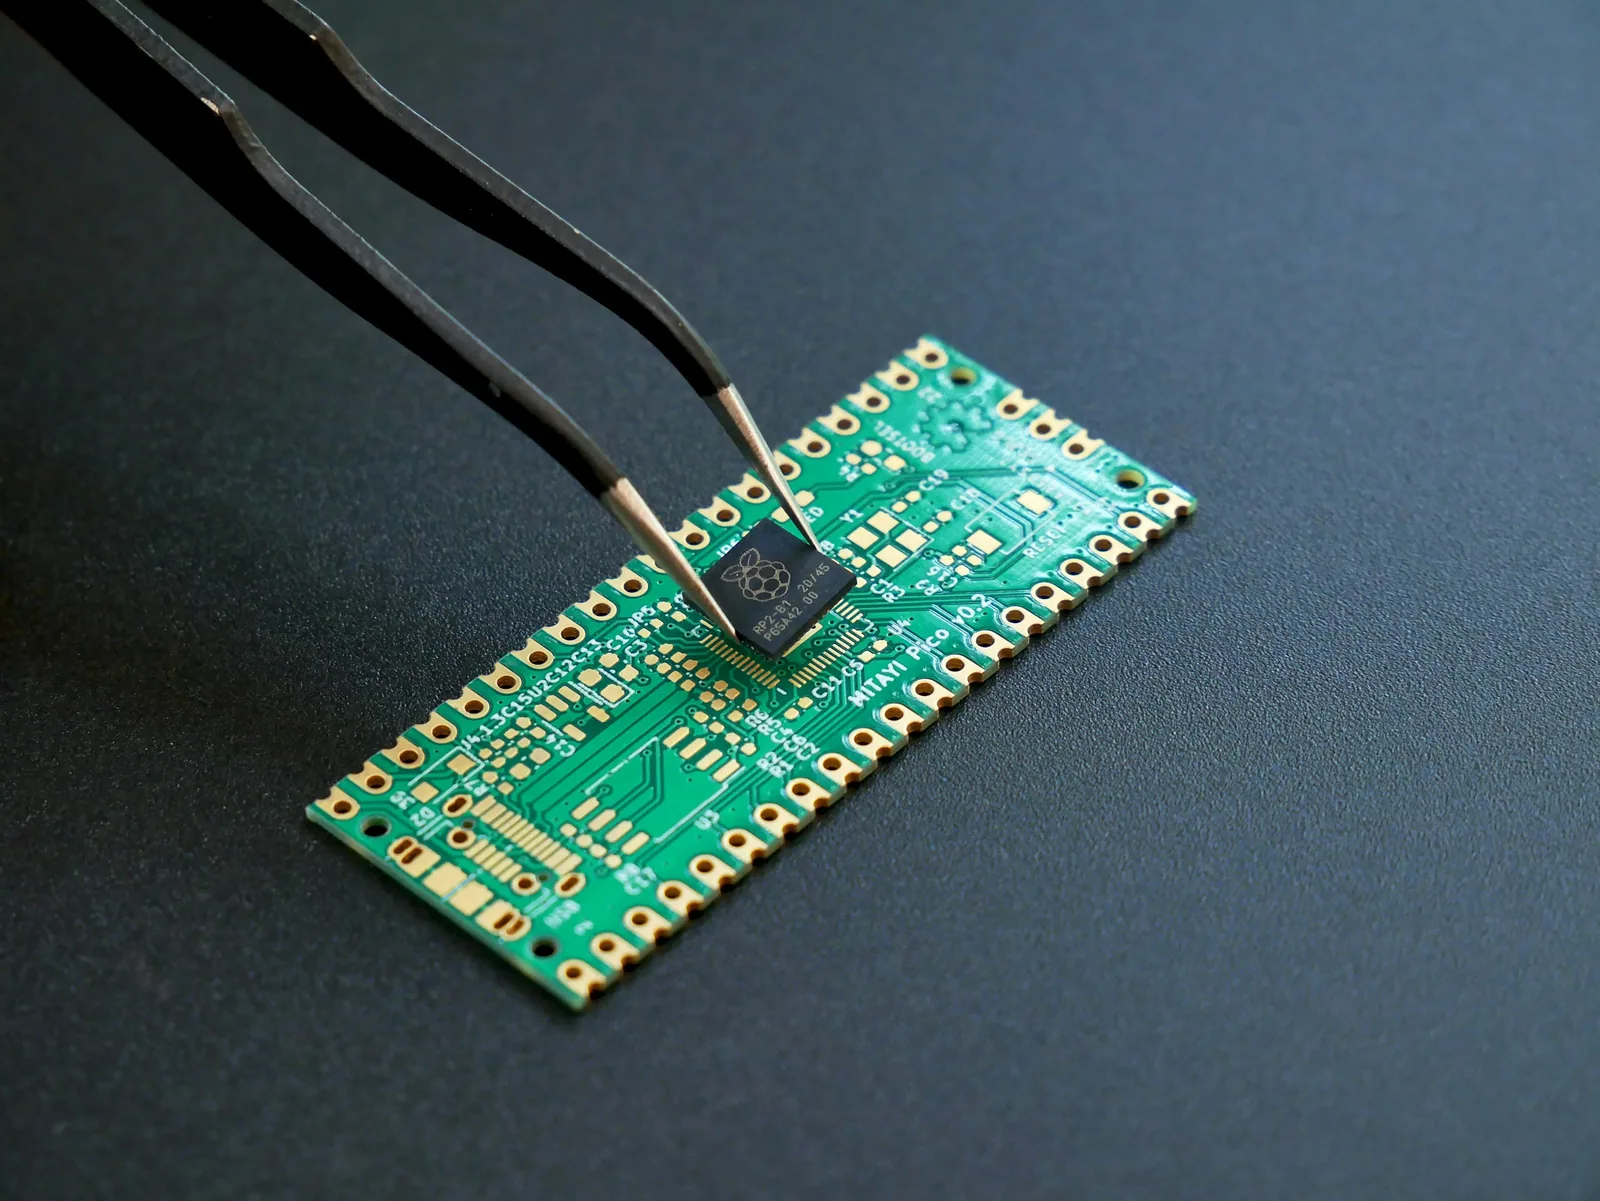
Foto: Vishnu Mohanan / Unsplash
Dopo aver letto questo articolo saprai:
- Spiegare i vincoli di memoria, calcolo e consumo di un modello su microcontrollore
- Descrivere il flusso TinyML dalla raccolta dei dati a un modello int8 nel firmware
- Individuare quali carichi di lavoro stanno su un microcontrollore e quali no
In questa pagina
Il TinyML è il machine learning che gira sui microcontrollori: chip senza sistema operativo nel senso desktop del termine, con al massimo qualche centinaio di kilobyte di RAM, un clock di decine o poche centinaia di megahertz e un budget energetico abbastanza piccolo da funzionare per mesi o anni con una batteria a bottone. È la fascia più bassa dell’edge AI, e quella con il maggior numero di dispositivi al mondo.
Il suo fascino sta nel fatto che un microcontrollore è già presente in quasi ogni dispositivo IoT. Se il modello riesce a stare nella memoria che avanza dopo il firmware, il dispositivo acquista la capacità di classificare ciò che vedono i suoi sensori senza una trasmissione radio, che di solito è la cosa più costosa che un nodo a batteria faccia. Un sensore di vibrazione che invia un byte, “normale” o “anomalo”, una volta all’ora invece di trasmettere in streaming i campioni grezzi può durare anni invece di giorni.
Questa guida spiega quali sono davvero i vincoli, come si costruisce un modello TinyML da un capo all’altro, quali framework sono di uso comune e quali carichi di lavoro si adattano bene e quali no.
Quali sono i vincoli, in ordine di gravità?
La memoria è il primo muro. Un tipico componente Cortex-M4 o ESP32 ha qualche centinaio di kilobyte di RAM, 520 KB nel caso dell’ESP32, e da uno a pochi megabyte di memoria flash. I pesi del modello risiedono nella flash; le attivazioni, cioè i risultati intermedi durante una singola inferenza, risiedono nella RAM. Un modello che su un telefono funziona con un file di pesi da 20 MB semplicemente non è un candidato. I modelli TinyML pratici vanno da pochi kilobyte a qualche centinaio di kilobyte.
Il calcolo è il secondo. Senza un’unità in virgola mobile, o con una lenta, l’aritmetica intera è l’unica opzione realistica. Un’inferenza che su un microcontrollore richiede pochi millisecondi può comportare qualche centinaio di migliaia di operazioni di moltiplicazione e accumulo, il che limita la profondità e la larghezza della rete.
L’alimentazione è il terzo e, nei prodotti a batteria, domina. Ogni millisecondo che il core passa sveglio costa energia, quindi il modello deve essere abbastanza veloce da permettere al dispositivo di tornare rapidamente in deep sleep. Il duty cycle dell’inferenza, cioè quanto spesso gira il modello, è spesso la manopola principale per regolare l’autonomia della batteria.
C’è un quarto vincolo facile da dimenticare: sul dispositivo non c’è Python. Il modello va convertito in un array statico di byte compilato nel firmware, e il runtime deve essere scritto in C o C++ senza allocazione dinamica della memoria.
Come si costruisce un modello TinyML?
Un progetto TinyML segue una sequenza fissa, e la maggior parte del tempo se ne va nel primo passo.
Raccogliere i dati dal sensore reale sull’hardware reale, nelle condizioni che il prodotto incontrerà. Un modello addestrato sulle vibrazioni di un banco di laboratorio non si trasferirà a un motore imbullonato su un telaio diverso. I dati devono essere etichettati, il che per il rilevamento delle anomalie può voler dire semplicemente “registrati durante il funzionamento normale”.
Progettare le feature e un modello. I dati grezzi dei sensori raramente vengono dati in pasto direttamente a una rete. L’audio diventa uno spettrogramma o un insieme di coefficienti MFCC; la vibrazione diventa una FFT o un insieme di caratteristiche statistiche calcolate su una finestra. Una piccola rete convoluzionale o completamente connessa classifica poi il frame di feature. L’estrazione delle feature è elaborazione deterministica del segnale e spesso costa più calcolo della rete stessa.
Addestrare nel cloud o su un portatile, con gli stessi framework di qualsiasi altro progetto. Poi quantizzare a interi a 8 bit. Qui la quantizzazione non è facoltativa: è ciò che fa stare il modello nella memoria e che gli permette di girare su hardware a interi.
Convertire il modello in un file flat, incorporarlo nel firmware come array di byte e collegarlo a un runtime. Poi misurare sul target: tempo di inferenza, picco di RAM e accuratezza su registrazioni di controllo fatte sul dispositivo. I numeri ottenuti sulla macchina di addestramento non contano.
Quali framework e runtime si usano?
LiteRT for Microcontrollers, in precedenza TensorFlow Lite for Microcontrollers e ancora sviluppato in modo aperto come progetto tflite-micro, è il runtime di riferimento. È un interprete C++ che legge un modello .tflite, funziona senza allocazione dinamica né dipendenze dalla libreria standard ed esegue un sottoinsieme configurabile di operatori. Lo sviluppatore alloca un buffer fisso, la “tensor arena”, per le attivazioni e registra solo gli operatori di cui il modello ha bisogno, il che mantiene piccolo il binario. Sui core Arm può usare i kernel CMSIS-NN, ottimizzati a mano per il set di istruzioni Cortex-M.
Edge Impulse è una piattaforma in hosting che incapsula l’intero flusso di lavoro: acquisizione dei dati da telefoni e schede di sviluppo, etichettatura, progettazione delle feature con un blocco DSP visuale, addestramento, quantizzazione, profilazione sul target ed esportazione come libreria C++ o libreria Arduino. È il punto d’ingresso più comune per i team con esperienza embedded ma senza uno specialista di ML.
Le NPU Ethos-U di Arm estendono la fascia dei microcontrollori con una piccola neural processing unit accanto a un core Cortex-M. Il compilatore Vela divide un modello quantizzato nelle parti che la NPU può eseguire e in quelle che ricadono sulla CPU. Diversi fornitori propongono componenti Cortex-M55 o Cortex-M85 abbinati a un core Ethos-U, il Renesas RA8P1 è un esempio, e questo porta la visione e l’audio sempre attivi entro budget energetici che i prodotti a batteria possono permettersi.
Altre opzioni includono toolchain specifiche dei fornitori, come ST Edge AI Core di STMicroelectronics, il successore di STM32Cube.AI, e la suite NXP eIQ, che generano codice ottimizzato per i rispettivi componenti. microTVM, che compilava i modelli in anticipo invece di interpretarli, è stato eliminato da Apache TVM nella release 0.19 e non è più un’opzione corrente.
Quali carichi di lavoro sono adatti?
Il riconoscimento di parole chiave (keyword spotting) è il compito TinyML per antonomasia: ascoltare in continuo in attesa di una parola di attivazione e risvegliare un sistema più grande quando la si sente. Il modello è piccolo, l’input è una breve finestra di spettrogramma e il requisito di latenza è permissivo.
Il rilevamento delle anomalie sulla vibrazione o sulla corrente, da un accelerometro o da una pinza amperometrica, è l’uso industriale più comune e la base di molti sensori per il monitoraggio delle condizioni. La guida alla manutenzione predittiva approfondisce l’elaborazione del segnale.
Il riconoscimento di gesti e attività da una IMU alimenta i wearable e gli utensili portatili, classificando finestre di movimento in una manciata di categorie.
La visione a bassa risoluzione, per esempio il rilevamento di persone su un frame in scala di grigi da 96 per 96, è fattibile sui microcontrollori più grandi e su qualsiasi cosa abbia un Ethos-U. Basta per rispondere a “c’è qualcuno?”, non per leggere una targa. La guida alla visione sul dispositivo spiega dove si ferma la fascia dei microcontrollori.
Le cascate di sensori combinano più di questi compiti: un modello economico sempre attivo decide se risvegliarne uno più costoso, che decide se risvegliare la radio. Ogni stadio filtra per il successivo, e il budget energetico è dominato dallo stadio più economico.
Quali carichi di lavoro non sono adatti?
Qualsiasi cosa con un ampio vocabolario di output, immagini ad alta risoluzione, un lungo contesto temporale o la necessità di aggiornare spesso il modello è un cattivo abbinamento. I modelli linguistici di qualsiasi dimensione utile sono fuori portata per questa fascia. Lo è anche qualsiasi compito per cui i dati di addestramento non possono essere raccolti sul dispositivo reale, perché un modello TinyML non ha capacità di riserva per generalizzare su hardware che non ha mai visto.
Il TinyML aggiunge anche un obbligo di manutenzione. Il modello è firmware, quindi aggiornarlo significa un aggiornamento OTA, e monitorarlo significa inviare a monte almeno un filo di campioni grezzi perché il drift del modello possa essere rilevato. Un dispositivo che può inviare solo un byte all’ora non può dirti quando ha cominciato a sbagliare.
Per continuare
- Edge AI spiegata tratta le fasce hardware più grandi, sopra il microcontrollore.
- Manutenzione predittiva con IoT e AI applica alle macchine l’elaborazione del segnale in stile TinyML.
- Tipi di dispositivi IoT e i vincoli che ne determinano la progettazione è il contesto hardware.
- Gestione dei dispositivi e aggiornamenti over the air spiega come distribuire un nuovo modello a una flotta.
- 17 ottobre 2026: microTVM rimosso dalle opzioni correnti (eliminato da Apache TVM nella release 0.19); ST Edge AI Core indicato come successore di STM32Cube.AI; nome LiteRT for Microcontrollers e dato sulla RAM dell'ESP32 con fonte; un dato sui consumi privo di fonte reso qualitativo; fonti collegate
Come gestiamo le correzioni: politica editoriale (in inglese).
Argomenti: TinyML, microcontrollori, TensorFlow Lite, Edge Impulse